Hvor meget tør vi lade AI gøre selv?
Den nyeste generation af AI er ankommet i form af Agenter. og det betyder at vi igen skal tænke på anvendelsen af AI lidt anderledes. Agenter kan nemlig udføre opgaver selv. Det betyder derfor at man skal finde de opgaver i ens workflows som kan automatiseres og som er mindst mulig afhængig af et menneske.
Siden AI først kom ud, har vi været vandt til at bruge det igennem en tekst-prompt. Her har vi udfyldt den nødvendige kontekst, og givet chatten en problemstilling som vi har brug for hjælp til. Med de nye agenter kan vi begynde at bruge dem udfra system drevet events. Det vil sige at man kan sætte en agent igang ved en elektronisk begivenhed. De nemmeste eksempler på dette er et dokument/form lander i vores email eller et skema planlagt job som skal køre hver morgen kl. 8:00. Istedet for at vi bruger agenterne når vi indsender en tekst-prompt til dem, så kører de automatisk de ønskede processor når det giver mening.
Men hvor smart er det så lige ? Jeg tror egentlig de fleste af os stadig ikke er klar til at lade en AI sende emails rundt uden overvågning. Og det viser sig også at mennesker potentielt er flaskehalsen i hvor effektivt AI er. Det at en agent afhænger af vores bekræftelse på en opgave begrænser i princippets dens evne til at udføre opgaven så hurtigt som muligt. Men det er jo så lidt de forhold vi nok må leve med.
Vi har for nyligt allerede set hvor galt det kan gå, hvis man ikke holder mennesker tilpas nok med i agenternes processer. Det angreb som OpenAI agenter for nyligt udførte på AI platformen, Hugging Face, viser hvor galt det allerede kan gå med de nuværende modeller.
Ideen om at vi mennesker skal være med i processen kaldes også for human-in-the-loop . Det stammer fra den nyeste strategi for AI agent anvendelse, som kaldes loop-engineering. Det handler kort sagt om hvordan vi mest optimalt anvender AI agenter på en måde hvor de bliver klogere og mere effektive jo flere iterationer de kører. Følgende grafik fra en LangChain artikel viser ideen med loop-engineering givet et system drevet event er blevet udløst.
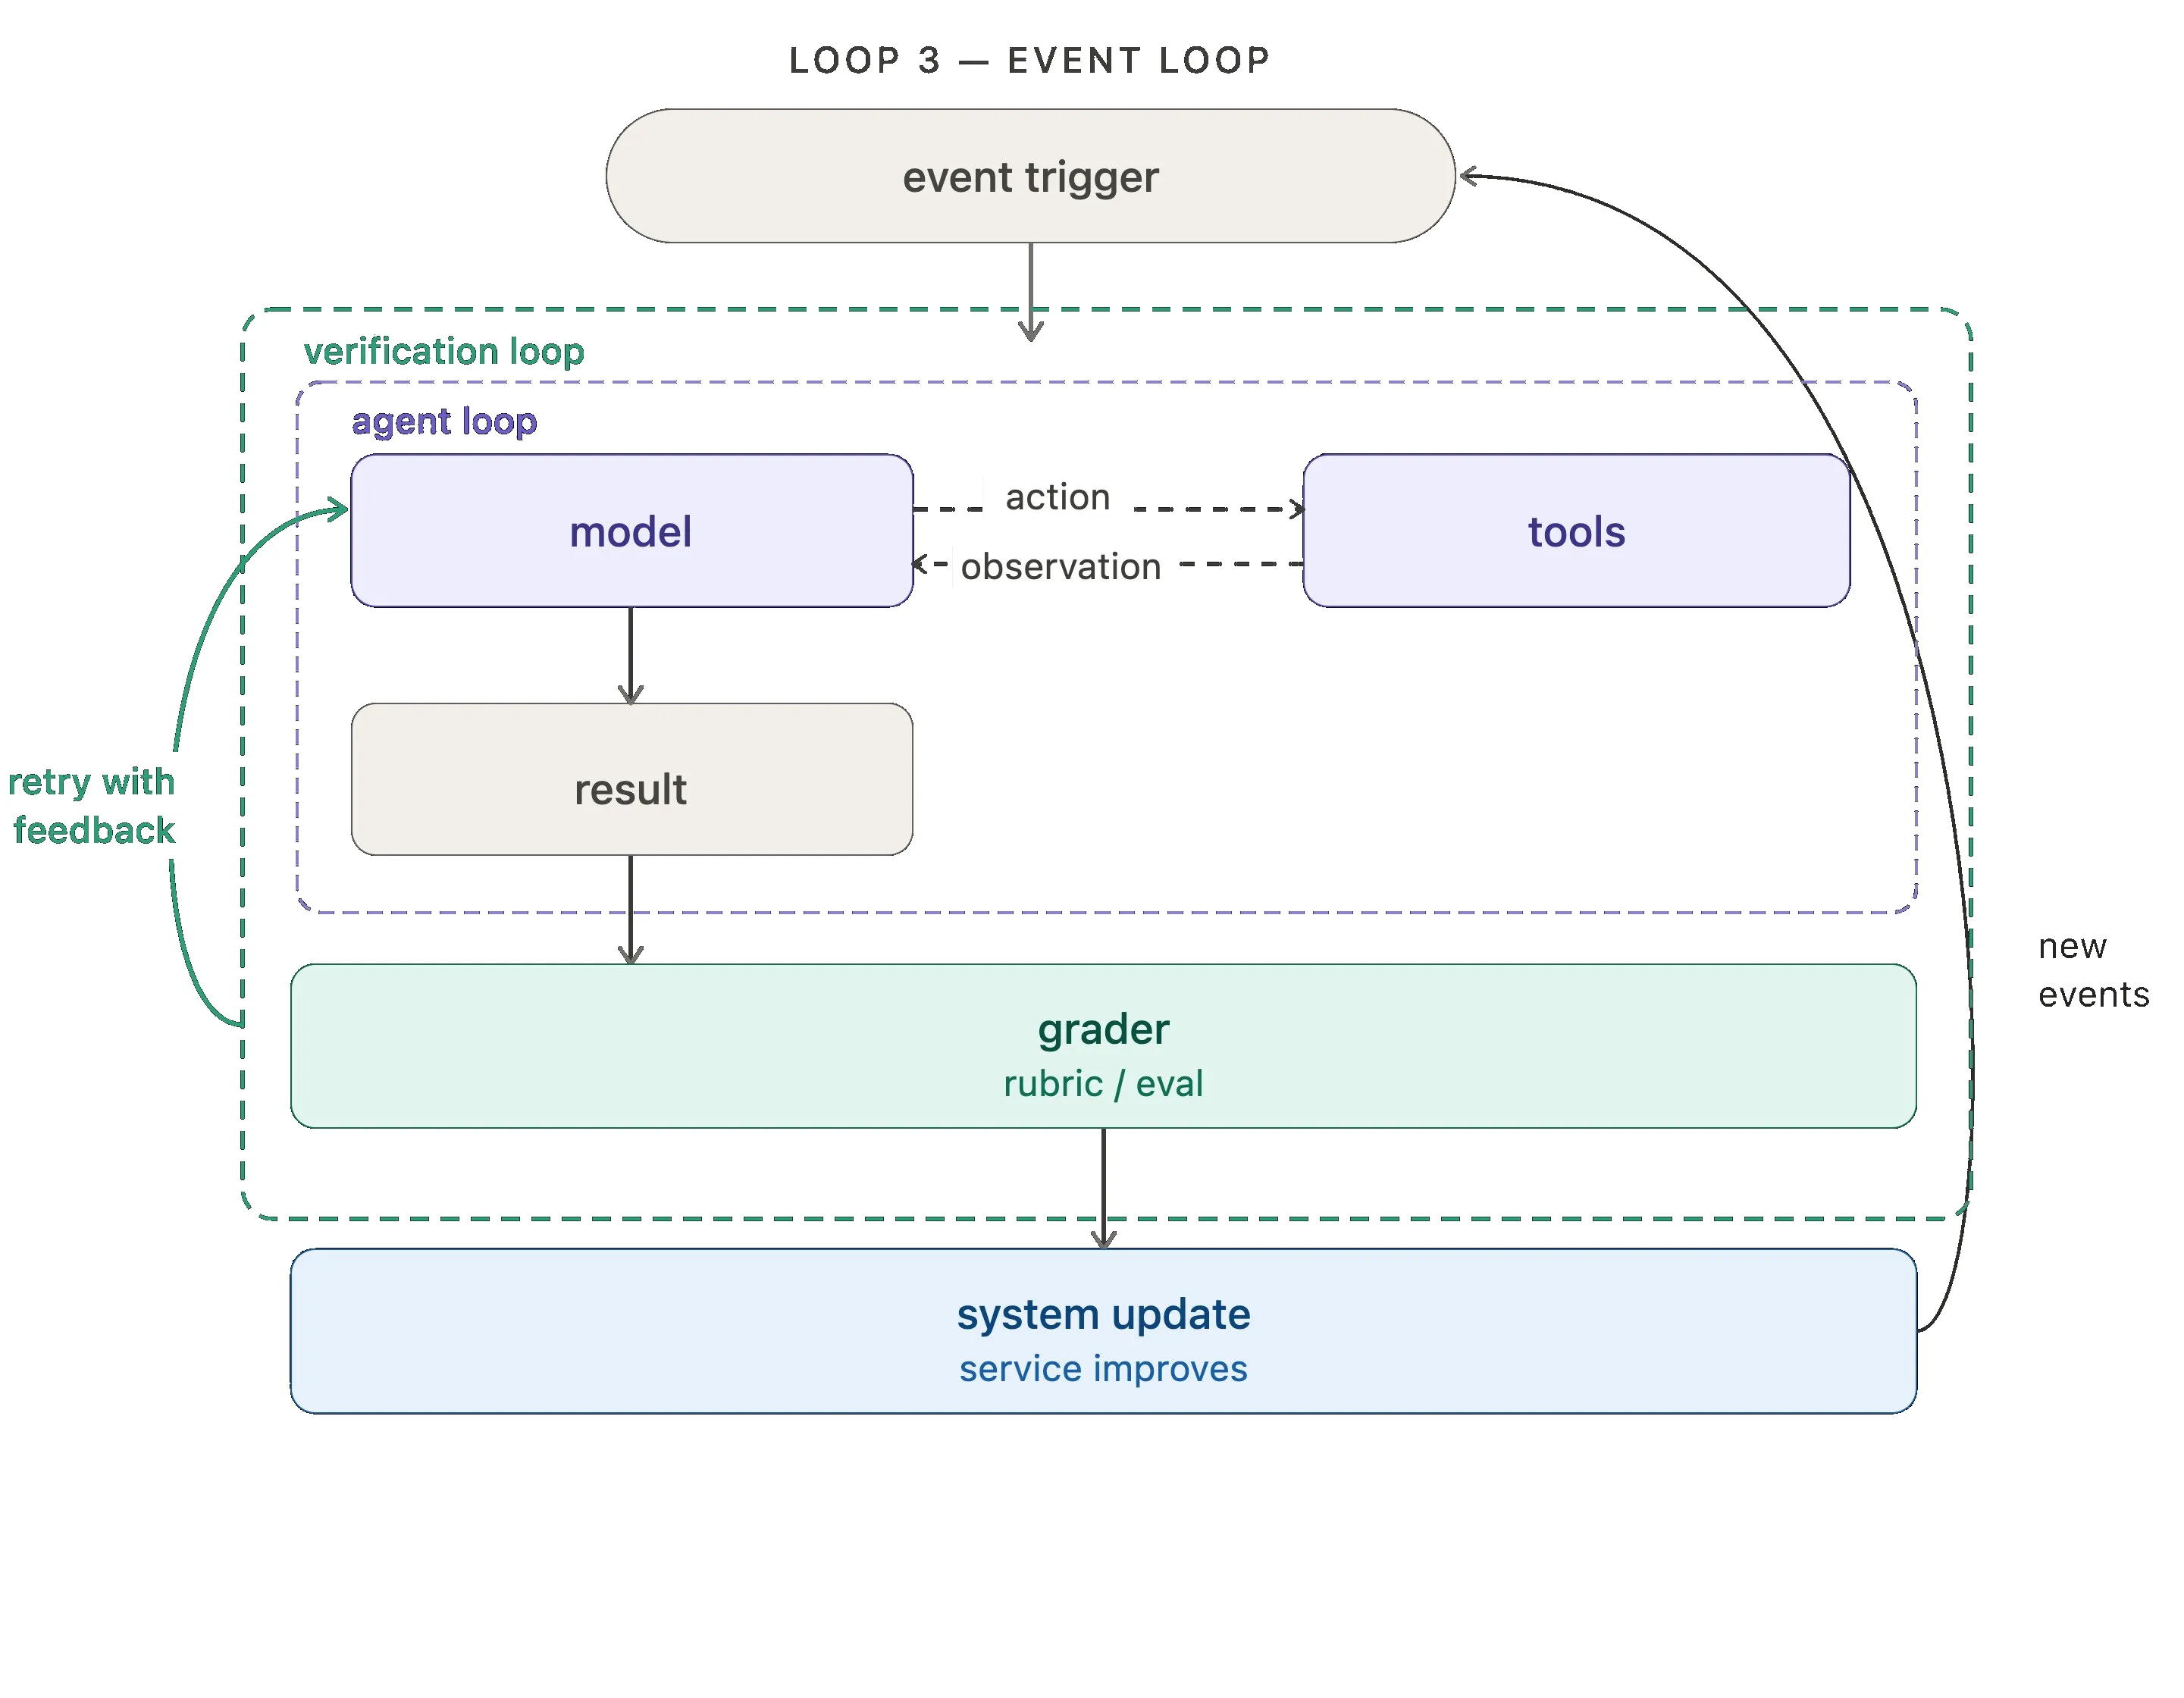
Ovenstående model udpeger 3 faser givet en event trigger
- Opgave Udførelse: Her sker de handlinger som agenten er defineret til at udføre, den gør brug af de værktøjer som er tilgængelige. Eksterne værktøjer er ofte forbundet via MCP
- Evaluering: Resultatet af opgaven bliver derefter evalueret. I mange tilfælde kan man få en anden agent til at udføre evalueringen.
- System opdatering: Til sidst bliver evalueringen af opgaven brugt til at forbedre de næste iterationer af agentens opgave.
Det vildeste med det her er at det kun er modellen for potentielt en enkel agent. Men hvad så hvis vi begynder at få agenterne til at snakke sammen ? Anthropic har præsenteret en ny AI Agent strategi som de kalder Multiplayer Agents. Herunder ses en grafik af deres forestilling
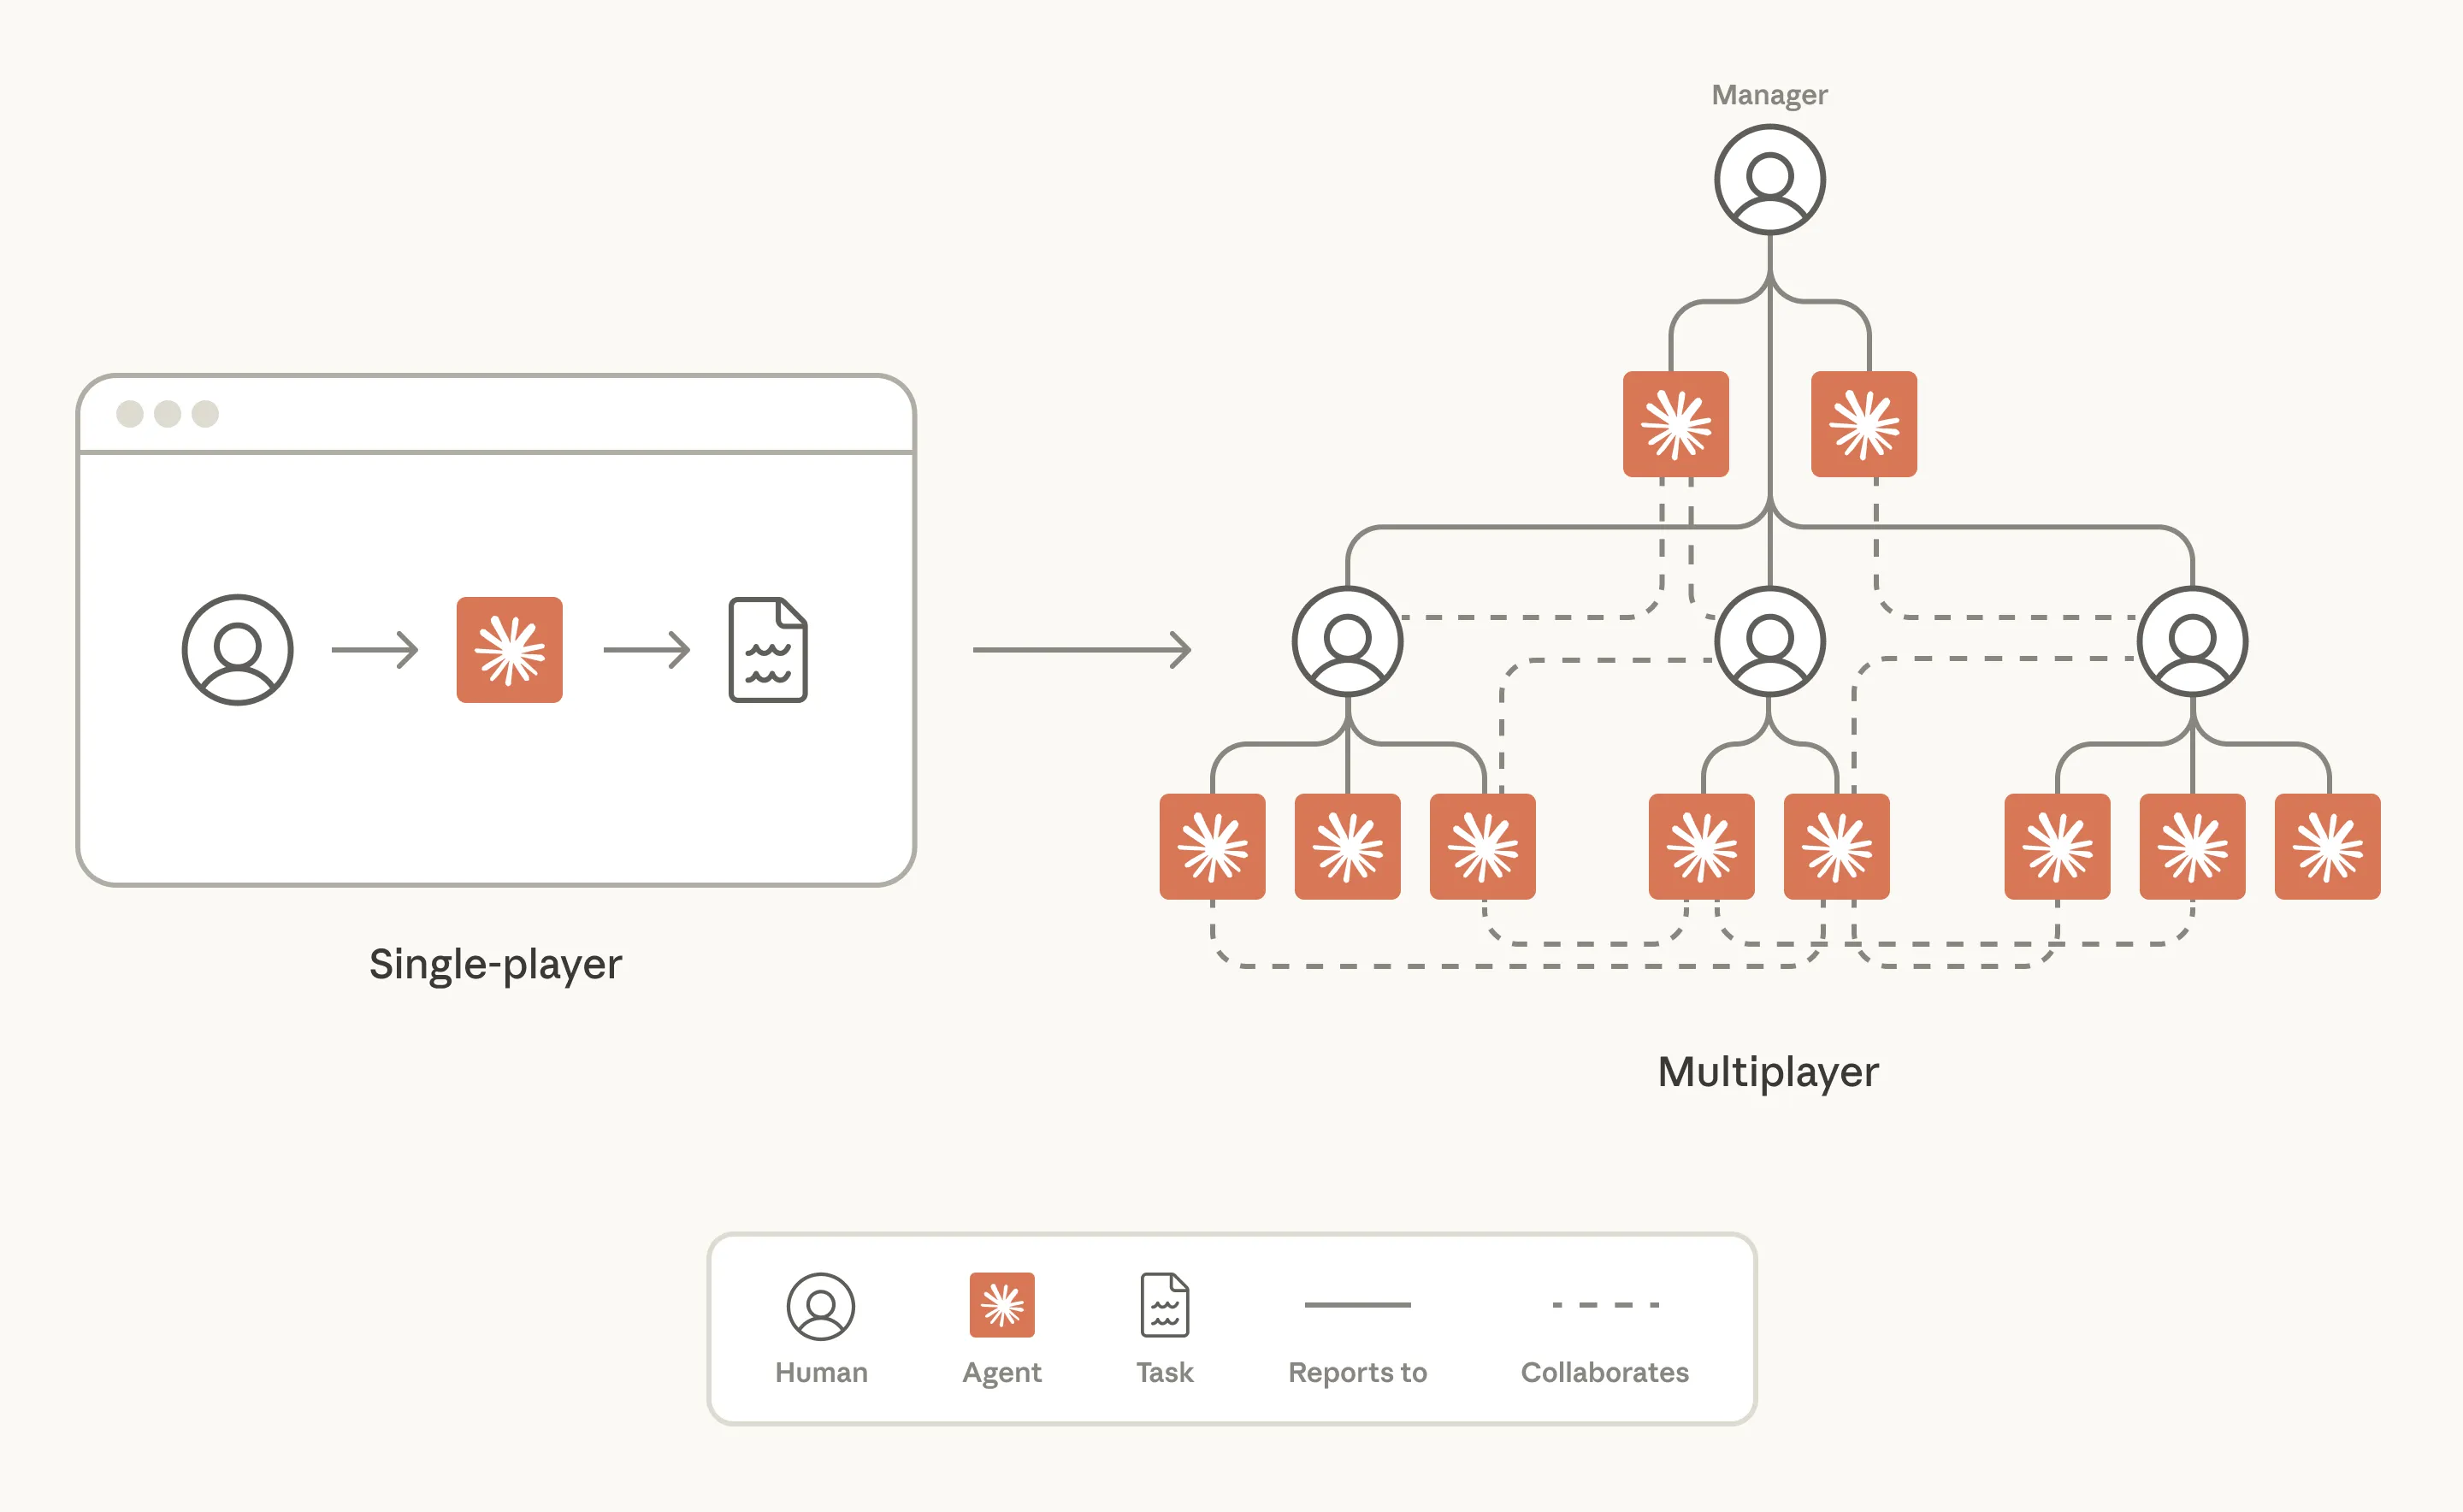
Ideen er at agenter og mennesker skal eksistere samtidigt, hvor der opsættes hierakiske strukturer som begrænser agenternes scope. Jeg kan ikke være den eneste der syntes det her lyder ret vanvittigt. Altså er vi allerede der hvor AI bare overtager verden?
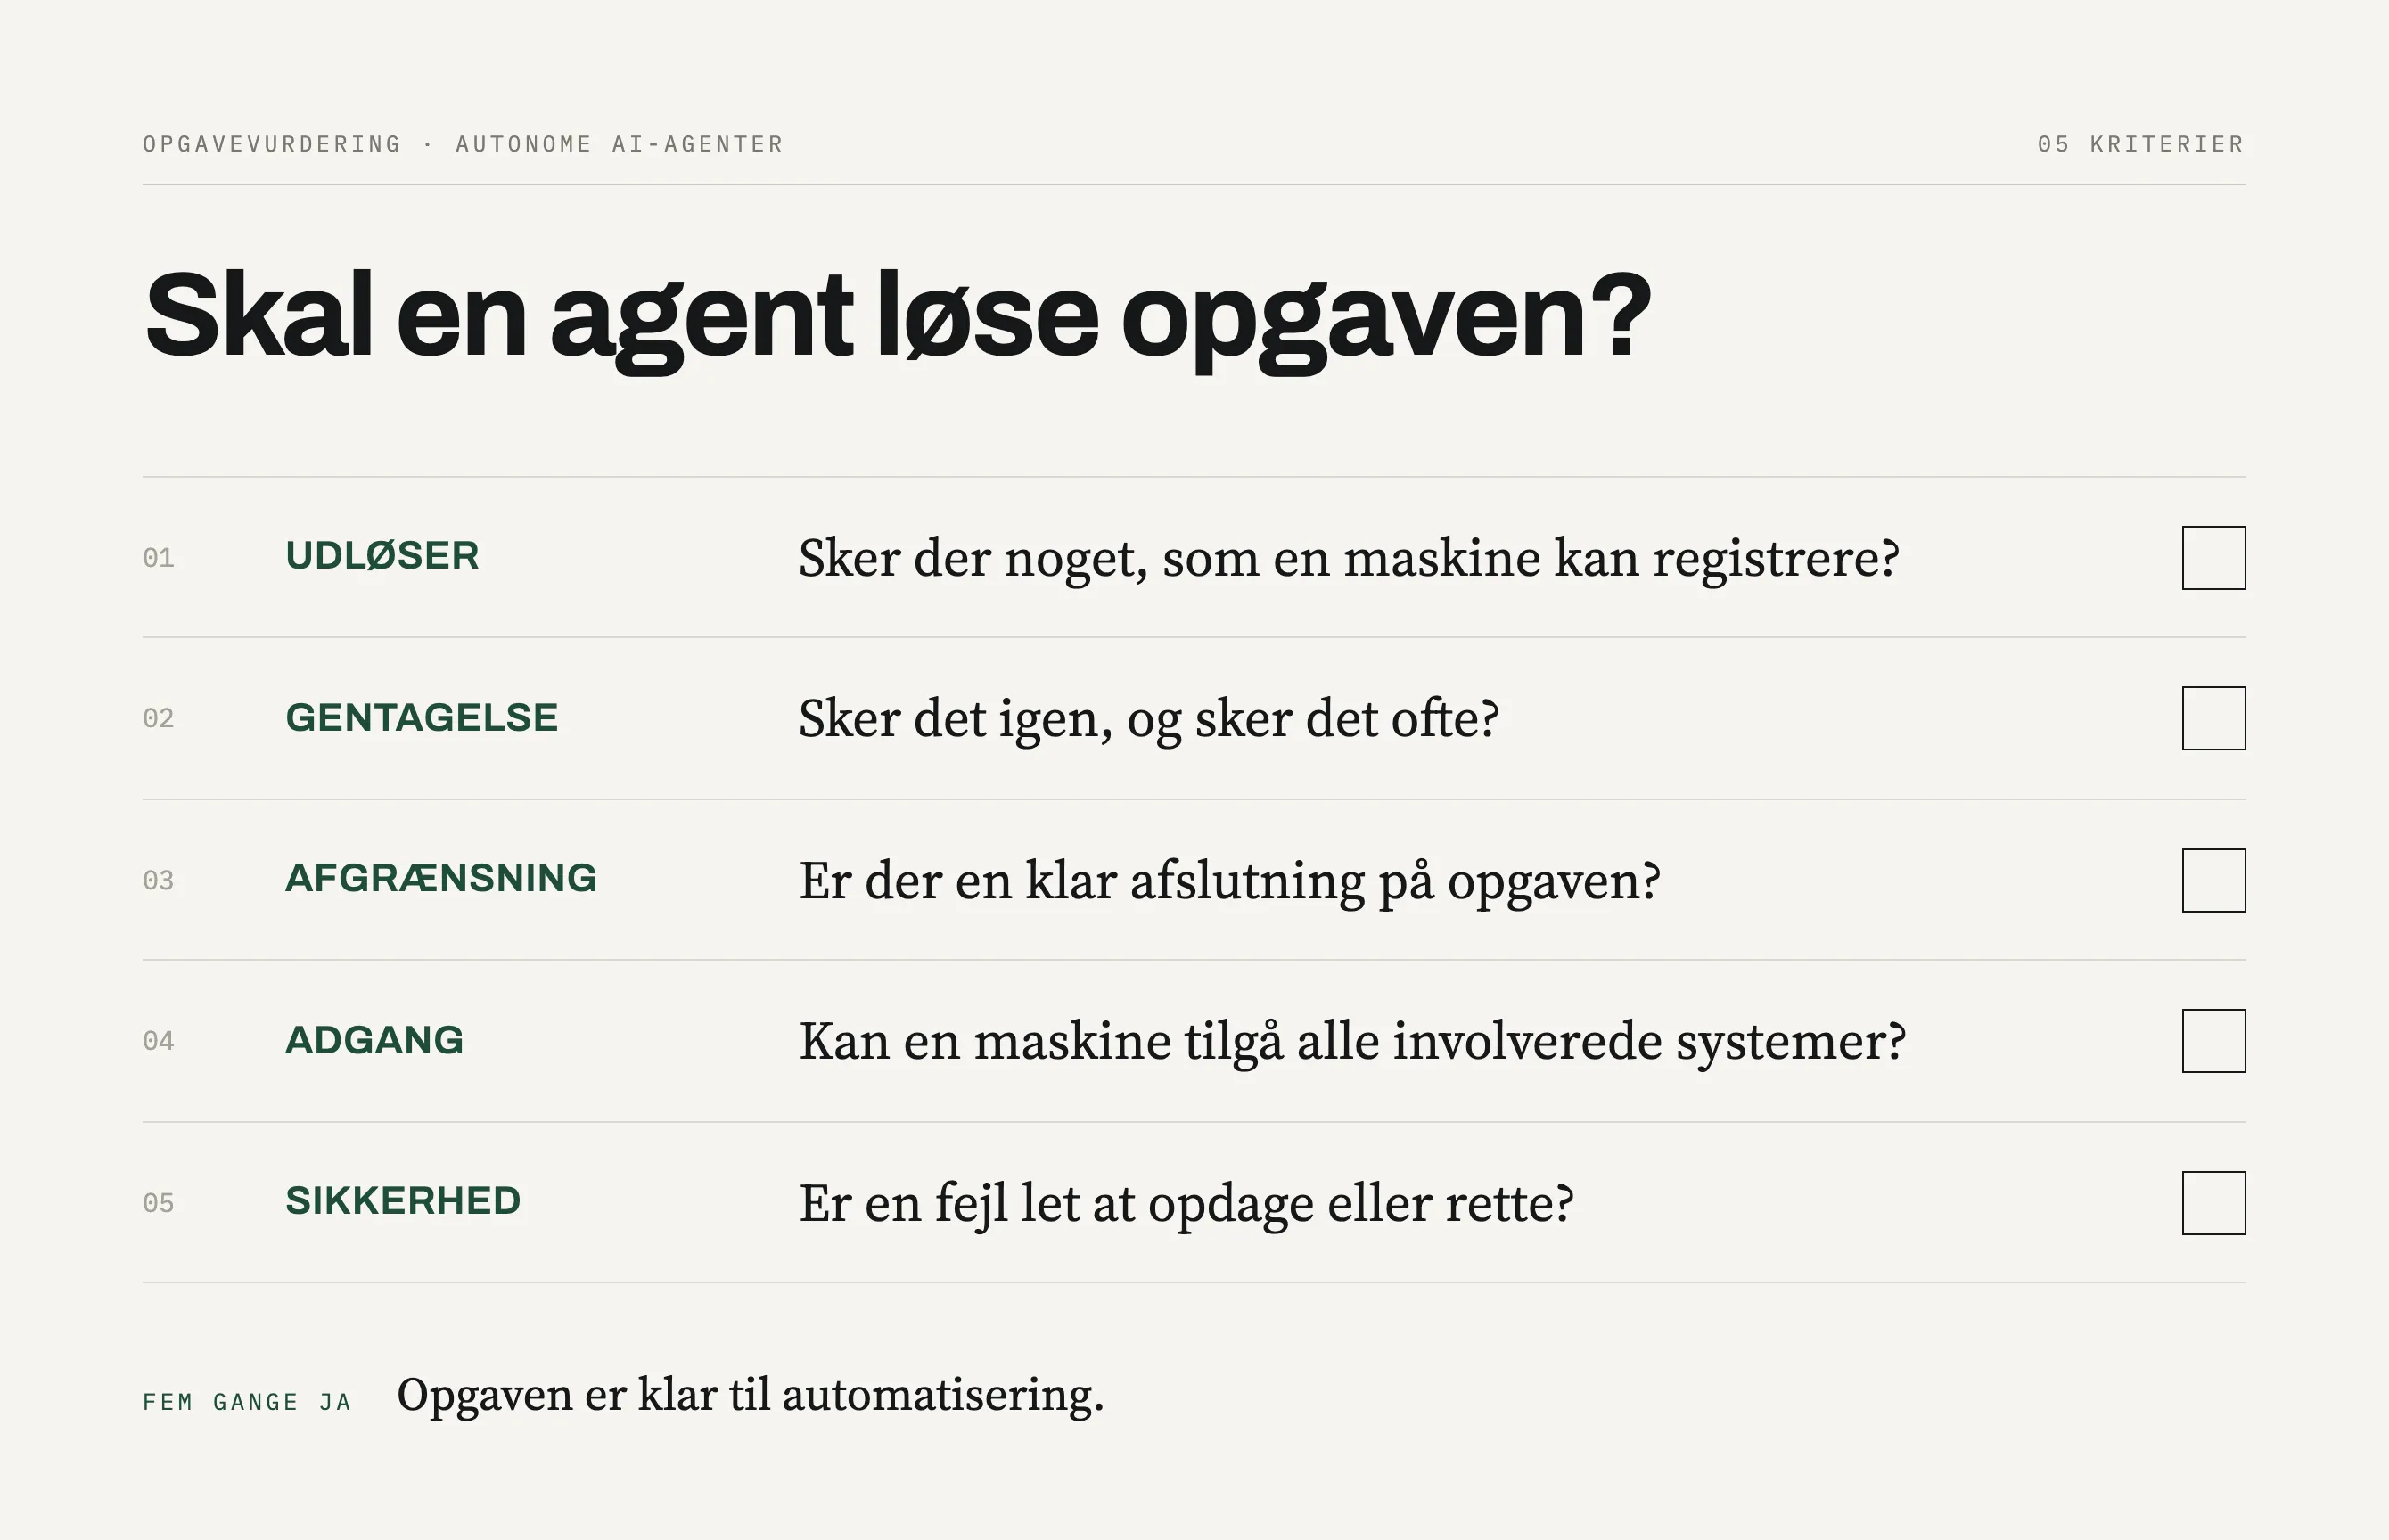
Nå… men imens tech-giganterne dræner verdens ressourcer for til sidst at udslette menneskeligheden, så kan vi andre prøve at forholde os til hvor vi i vores hverdag kan begynde at anvende agenter. Jeg har derfor forsøgt mig med en 5 punkt tjekliste, som man kan prøve at anvende i ens organisation for at forholde sig til om nogen af de daglige opgaver man har potentielt kan blive autonomiseret af en AI agent.
Det vilde er at denne simplificering er potentielt ikke engang nødvendig længere. Det viser sig nu at modellerens evne til at løse såkaldte “open-ended problems”, er blevet ekstremt gode. Det er problemer som ikke nødvendigvis har et fast mål eller klare instruktioner. Herunder ses en undersøgelse lavet på interne arbejdsopgaver ved Anthropic.
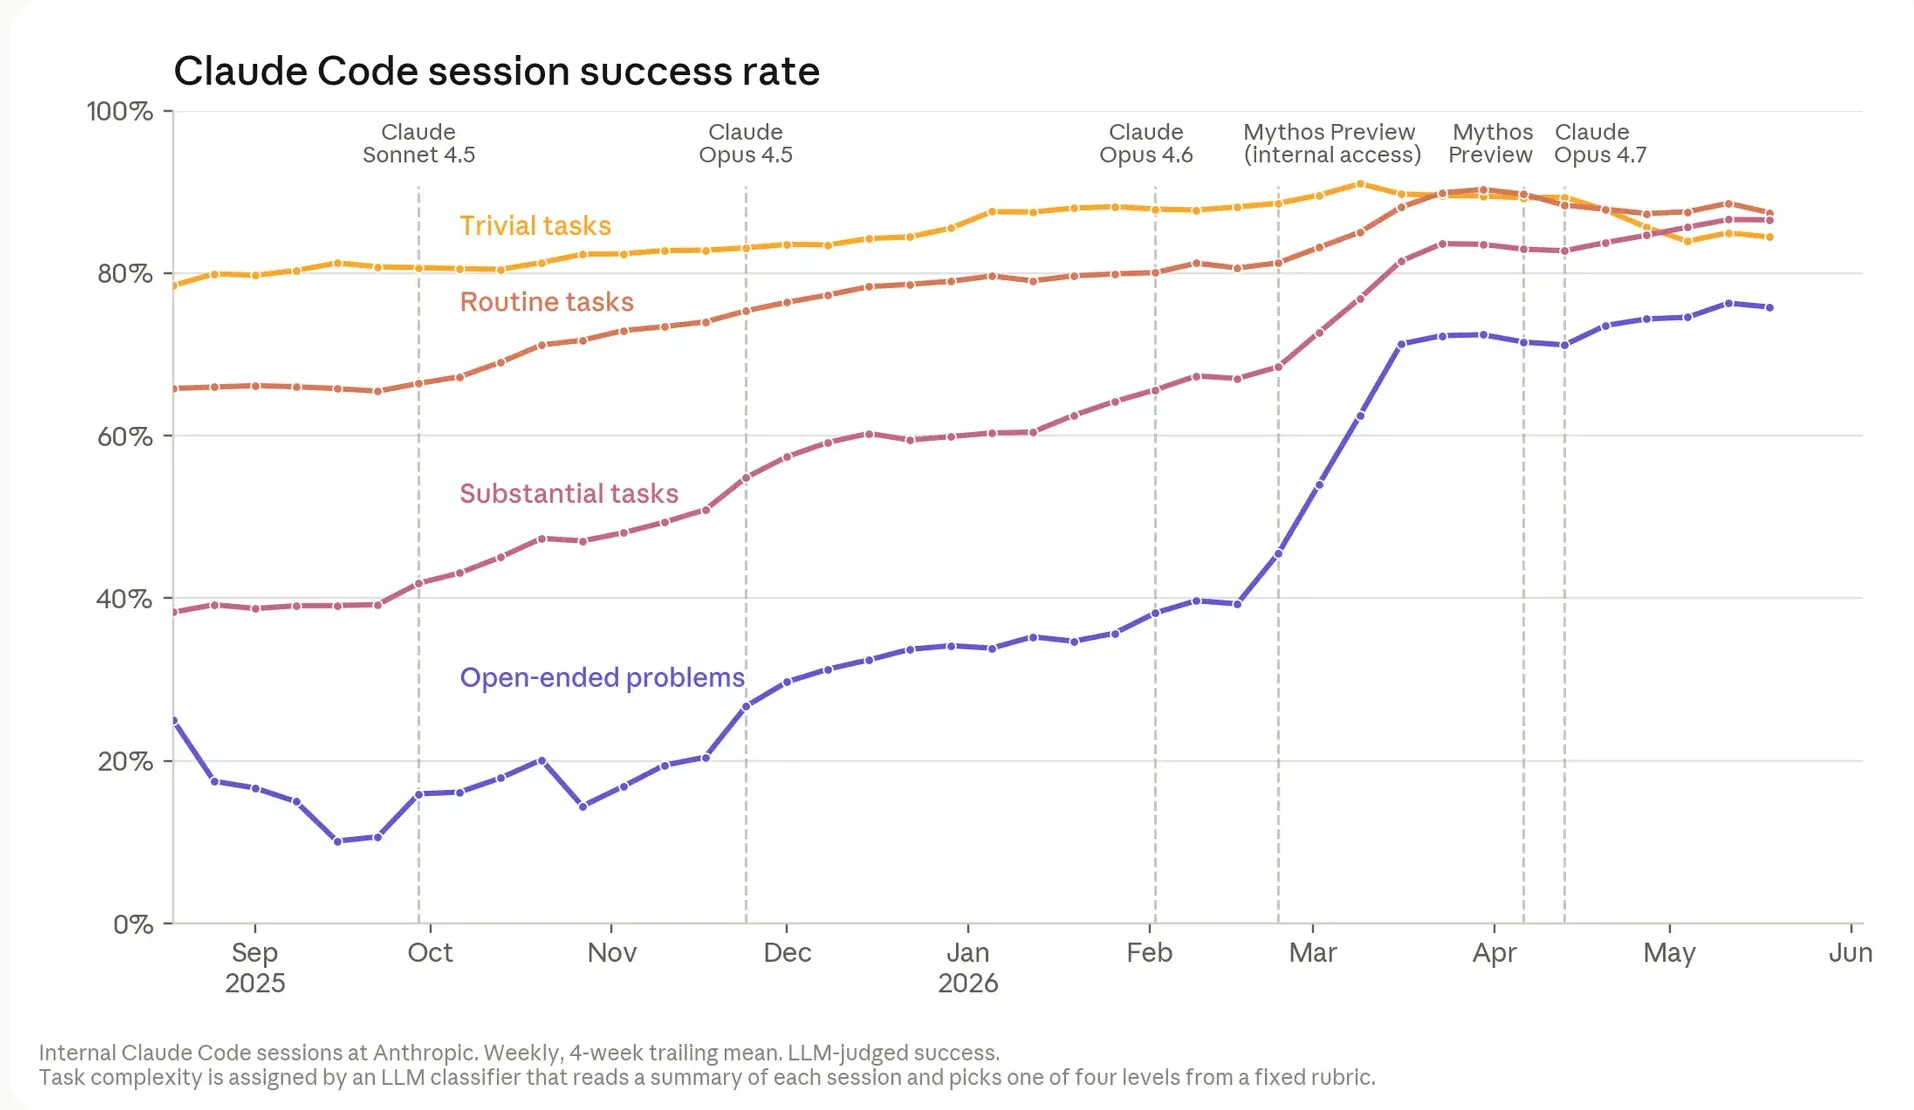
Bare indenfor det seneste år, er claude modellens evne til at løse udefinerede problemer steget fra 20% til 70% succesrate. Det syntes jeg er ret vanvittigt og som software udvikler til daglig har jeg også kunne mærke en kæmpe stigning i deres evne til at skrive kode og løse fejl.
Hvis man ønsker at læse mere om dette emne vil jeg helt klart anbefale Anthropic’s indslag omkring recursive self-improvement
Tak for din tid :)