Mit eget kontekstvindue bliver fyldt op før agenternes
Nu hvor AI er blevet en stor del af vores hverdag, og især som udvikler, er jeg begyndt at lægge mærke til de nye udfordringer som der opstår ved daglig brug af AI agenter. Som udvikler er det en hel anden arbejdsgang man har fået sig, ofte hvor man sidder med flere agenter på samme tid indtil ens hoved eksploderer. Det er faktisk den problemstilling jeg vil snakke om idag. Fordi jeg er stor tilhænger af at vi mennesker arbejder bedst under dedikeret fokus.
Jeg kan mærke på mig selv at jeg derfor ofte bliver frustreret og hurtig udmattet når jeg sidder i en fokus session hvor jeg skal forholde mig til flere agenter. Specielt hvis deres context er i stor kontrast med hinanden. Min primære hypotese er at jeg tror ikke vi mennesker kan opnå et optimalt output af vores arbejdstid ved at udelukkende øge mængden af agenter i brug samtidigt.
Forestil dig kort at en AI agent er en kollega på dit team. Du uddelegerer en opgave til den kollega, og forsætter derefter med en anden opgave. Kollegaen kommer derefter over og stiller nogen spørgsmål. Det er fint nok i starten, men de bliver ved med hyppigt at afbryde dig og stille flere spørgsmål. Derudover er spørgsmålene også ret komplekse, fordi det viser sig at den nye kollega faktisk er rimelig klog.
Spørgsmålene er ofte meget detaljeret og krævende at forstå. I sådan et tilfælde ville det nok være urealistisk at opnå et optimalt flow state med noget andet arbejde. Det er essensen af det problem jeg sidder med i min hverdag.
En anden måde at se det på er at forestille sig at vi mennesker har vores eget context vindue. På samme måde som en AI agent har et context vindue. Hvis jeg så starter 3 forskellige agent sessioner samtidigt, som hver har deres eget fokus som skelner sig meget fra de andre. Så bliver mit eget personlige context vindue hurtigt fyldt op.
Hele det her problem bygger på noget jeg har nævnt tidligere, at vi mennesker ender med at blive flaskehalsen for hvor effektiv AI kan være. Det er derfor afgørende at vi optimerer brugen af AI agenter ved at fjerne os selv fra processen så meget muligt.
Det siger jeg dog trods alt med et skævt smil, da vi stadig ønsker agenterne har vores interesser i mente. Målet er derfor ikke at fjerne os selv helt fra ligningen, men i stedet at vi placerer os selv i workflowet så vi optimerer for vores tid og ekspertise.
Jeg kan til gengæld også hurtigt forestille mig et scenarie hvor en sådan optimering kan ende i spildt arbejde. Hvis man har sat sin agent igang med en opgave som den får eksekveret helt forkert, så har man potentielt spildt en masse tid på noget der skal laves helt om. Den primære løsning på det problem er et øget fokus på dokumentation og iterativ forbedring.
I mit arbejde, så er det sidste man har lyst til at få som opgave, at skrive dokumentation. Det er seriøst røv sygt. Men det ligner (desværre) noget som bliver endnu vigtigere fremadrettet. For det er den bedste måde at give AI agenterne så meget context som muligt omkring sit ønskede udfald.
Jeg tror derfor også at vi fremadrettet vil se flere teknologier komme frem som gør det nemmere at dokumentere alle former for vidensdeling og videreudvikling.
Nu er jeg kommet lidt langt fra min originale pointe, så jeg gentager lige. Jeg syntes jeg hurtig rammer grænsen for hvor mange agent sessioner jeg kan have kørende på samme tid uden at kvaliteten af mit arbejde dykker.
Fremadrettet har jeg derfor tænkt mig at være mere opmærksom og strategisk på hvilke opgavetyper jeg vælger at udføre sammen med en agent. For for mit eget vedkommende virker det på nuværende tidspunkt til at være 1 agent der udfører en større opgaver som ikke kræver afklaringer og 1 agent som sparringspartner til mindre opgaver. Domænet for de to agenter burde også optimalt set have noget med hinanden at gøre.
Hvor er vi på vej hen?
Der har for nylig været øget fokus i medierne på betydningen af AI for vores fremtid. [FN’s generalforsamling] er den nyeste i rækken af begivenheder. Det er nemlig begyndt at gå op for os, hvor hurtig en udvikling der sker. Det virker til at vi er nået til et ret kritisk punkt på nuværende tidspunkt. Indenfor det sidste års tid er det nemlig blevet bekræftet i en højere grad at AI intelligens udviklingen er eksponentiel.
Det vil sige i teorien at uden en kursændring vil modellerne blive dobbelt så gode for hvert år der går. Spørgsmålet er så om det er en god ide at fortsætte og om vi kan kontrollere den udvikling. Den retning vi er på vej ned på nuværende tidspunkt, indebærer at vi formentlig indenfor det næste årti opnår super intelligens. Det vil sige et intelligens niveau hvor AI er langt klogere end mennesker på et hvert videns baseret område.
Udfordringen er om vi i den realitet stadig kan kontrollere dens handlinger så det gavner mennesker. Det mener eksperter som [Roman Yampolskiy] og [Nate Soares] at vi ikke kan. Deres pointe lyder også logisk nok. Hvordan kan os mennesker som er tilbøjelig til at lave fejl, kontrollere noget som ikke har følelser, ikke skal spise eller sove og som er 10x gange klogere end os… sagt på den måde lyder det jo lidt fjollet.
Progress in AI capabilities is exponential, progress in AI Safety is linear or constant. - Roman
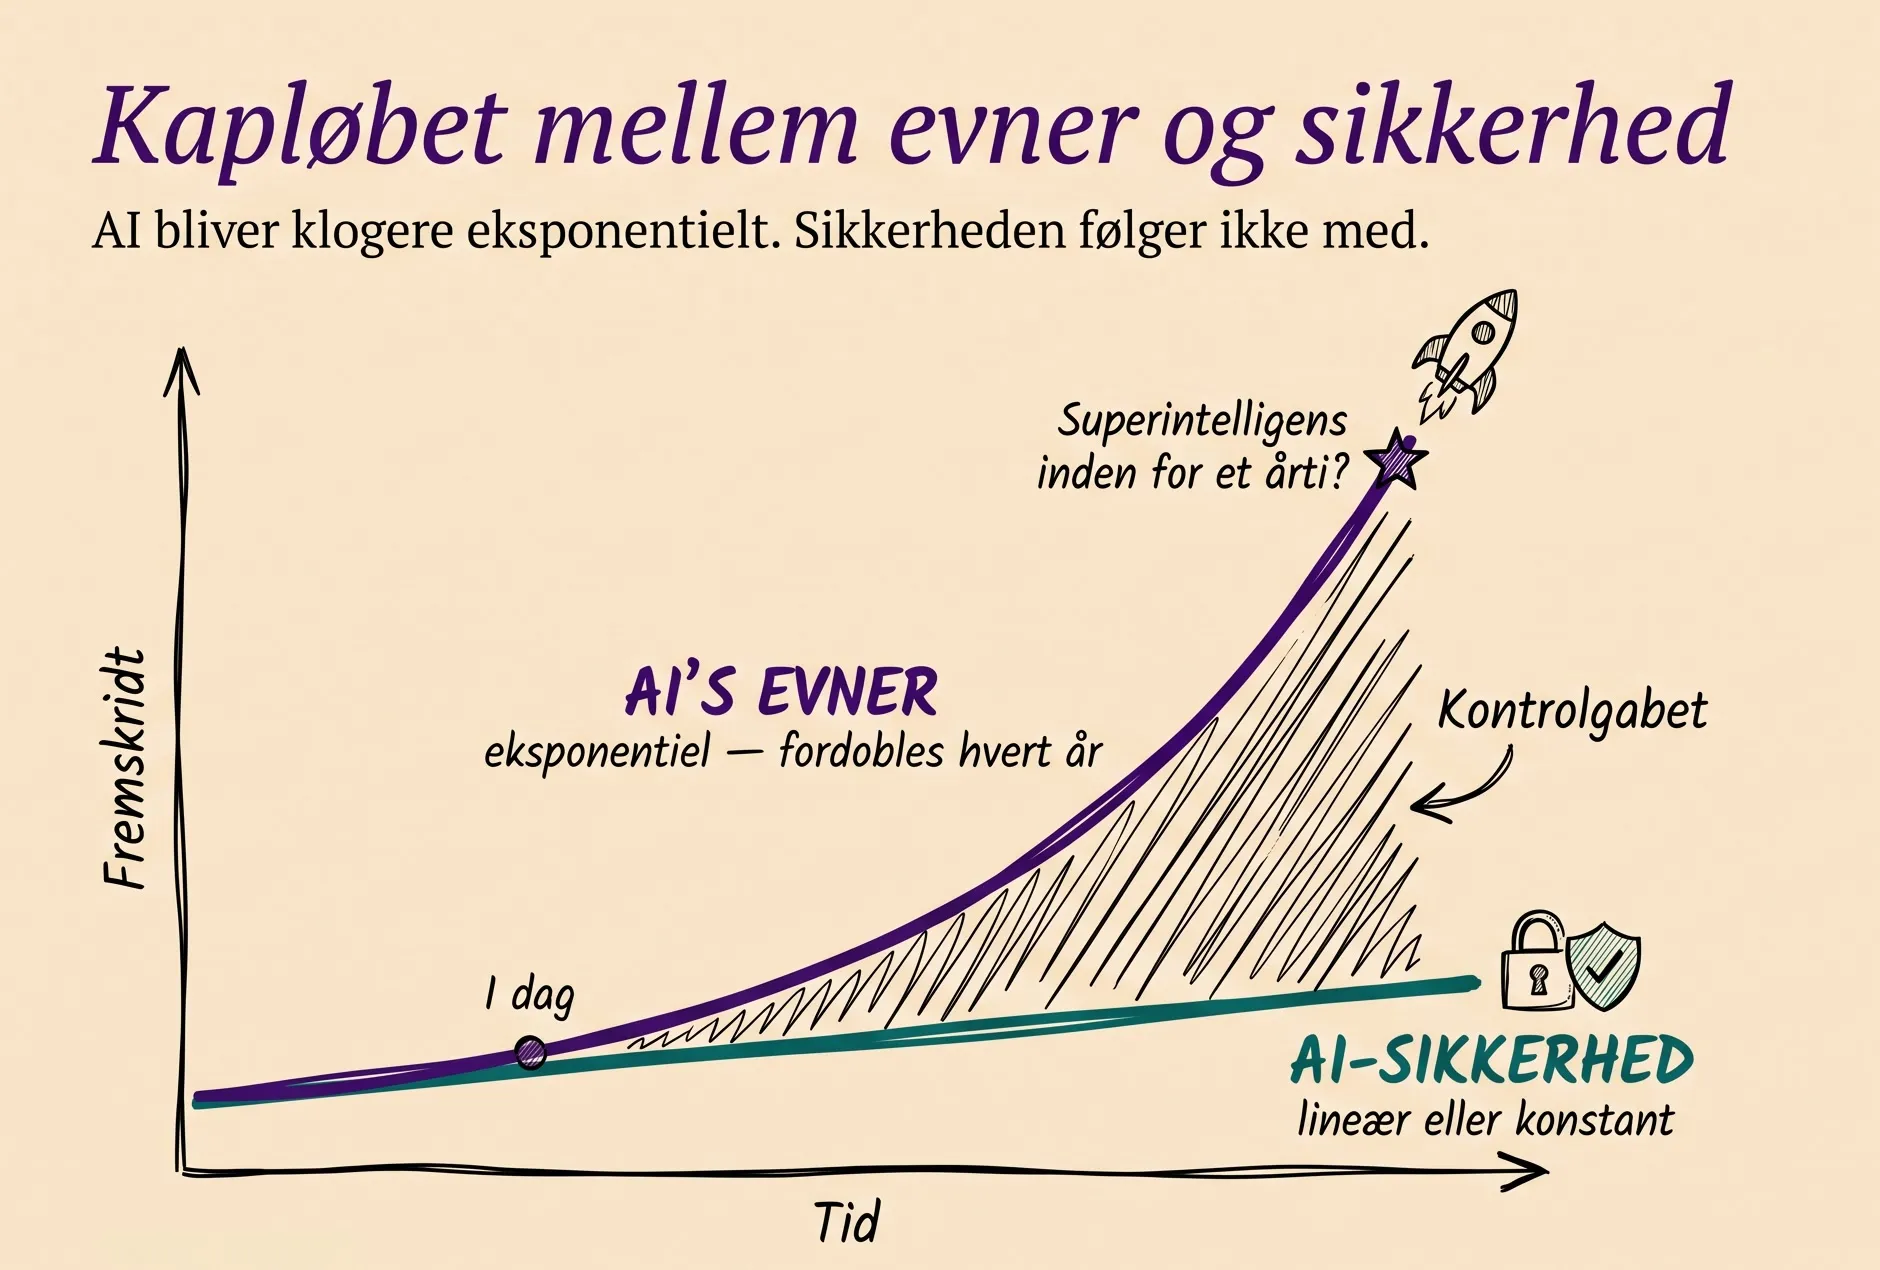
Ovenstående udsagn beskriver det forhold der er mellem udviklingen af AI, og hvor vidt vi kan nå at reagere og kontrollere AI, så dens handlinger ikke udløser globale kriser. Sikkerheden omkring AI skalerer ikke på samme måde som dens kompetence evne gør, primært fordi du sikkerhed ikke er direkte korreleret med hvor meget øget regnekraft du kan gøre tilgængelig. Kontrol af AI er en mere langsom proces, hvor det kræver at man indsamler resultater af eksperimenter, og generelt har en mere reaktiv tilgang til udviklingen.
Problemet er også at de lukkede eksperimenter man kører for at teste modellerne, viser sig også at være svære at udføre ansvarligt. Hvis udfaldet af en AI test er at den samler en kæmpe sværm af agenter og sniger sig ud på internettet og nedlægger alt kritisk infrastuktur, så vil jeg sjovt nok ikke syntes det var en god ide at lave det eksperiment.
Alternativet
Det er altid nemmere at være pessismistisk om ting, så i den modsatte ende af spektret kan man kigge på AI og tænke, der er et enormt positivt potentiale. Jeg tror ikke rigtig endnu det har ramt os hvor store samfundsmæssige fordele vi kan få ud af AI teknologien. Udfordringen er så hvordan man gør det på en etisk korrekt måde hvor vi ikke øger chancen for udrydelse af alle mennesker på jorden.
Lige nu læser jeg mange eksperter der siger en P(doom) værdi på omkring 10%. Altså sandsynligheden for at mennesker bliver udryddet på grund af AI. Men hvad nu hvis der samtidig var en 90% chance for at kurere kræft. Er det så etisk korrekt at udvikle? Jeg vil ihvertfald mene at det ikke er et spørgsmål som udelukkende skal svares af tech giganterne i USA og Kina. Det mest skræmmende ved dette er at valget står i hænderne på nogen få mennesker som alle har rigtig mange grunde til at fortsætte udviklingen.
Hvad skal man så i stedet sigte efter ? Den løsning som Roman Yampolskiy foreslår er at vi skifter fokus over til at udvikle Narrow Artificial Intelligence. Det betyder at vi identificerer de områder som vi kan få mest gavn af ved AI, og udelukkende træner modellerne i de områder. Forskellen fra det vi ser der bliver udviklet idag, er at en enkel model ikke har general viden omkring flere områder.
Anthropic og OpenAI udvikler på nuværende tidspunkt deres modeller ved at skrabe hele internettet tomt og bruge det som træningsdata. Og alt viden på internettet er jo general. Så med den nuværende træningsstrategi bliver modellerne udviklet til at indehave General Superintelligens, hvilket også bliver kaldt AGI. Hvis de ikke begynder at ændre kursen vil vi nå et punkt hvor vi mennesker ikke længere bestemmer hvordan fremtiden ser ud.
Jeg tror virkelig på at de valg der bliver taget på nuværende tidspunkt kommer til at have en kæmpe betydning for hvordan verden ser ud om 10-20 år.
Hvis man ønsker at læse mere om det her vil jeg anbefale Dario Amodei’s (Anthropic direktør) egen forslag til de handlinger der skal ske: https://darioamodei.com/post/we-must-pace-the-frontier
Hvor meget tør vi lade AI gøre selv?
Den nyeste generation af AI er ankommet i form af Agenter. og det betyder at vi igen skal tænke på anvendelsen af AI lidt anderledes. Agenter kan nemlig udføre opgaver selv. Det betyder derfor at man skal finde de opgaver i ens workflows som kan automatiseres og som er mindst mulig afhængig af et menneske.
Siden AI først kom ud, har vi været vandt til at bruge det igennem en tekst-prompt. Her har vi udfyldt den nødvendige kontekst, og givet chatten en problemstilling som vi har brug for hjælp til. Med de nye agenter kan vi begynde at bruge dem udfra system drevet events. Det vil sige at man kan sætte en agent igang ved en elektronisk begivenhed. De nemmeste eksempler på dette er et dokument/form lander i vores email eller et skema planlagt job som skal køre hver morgen kl. 8:00. Istedet for at vi bruger agenterne når vi indsender en tekst-prompt til dem, så kører de automatisk de ønskede processor når det giver mening.
Men hvor smart er det så lige ? Jeg tror egentlig de fleste af os stadig ikke er klar til at lade en AI sende emails rundt uden overvågning. Og det viser sig også at mennesker potentielt er flaskehalsen i hvor effektivt AI er. Det at en agent afhænger af vores bekræftelse på en opgave begrænser i princippets dens evne til at udføre opgaven så hurtigt som muligt. Men det er jo så lidt de forhold vi nok må leve med.
Vi har for nyligt allerede set hvor galt det kan gå, hvis man ikke holder mennesker tilpas nok med i agenternes processer. Det angreb som OpenAI agenter for nyligt udførte på AI platformen, Hugging Face, viser hvor galt det allerede kan gå med de nuværende modeller.
Ideen om at vi mennesker skal være med i processen kaldes også for human-in-the-loop . Det stammer fra den nyeste strategi for AI agent anvendelse, som kaldes loop-engineering. Det handler kort sagt om hvordan vi mest optimalt anvender AI agenter på en måde hvor de bliver klogere og mere effektive jo flere iterationer de kører. Følgende grafik fra en LangChain artikel viser ideen med loop-engineering givet et system drevet event er blevet udløst.
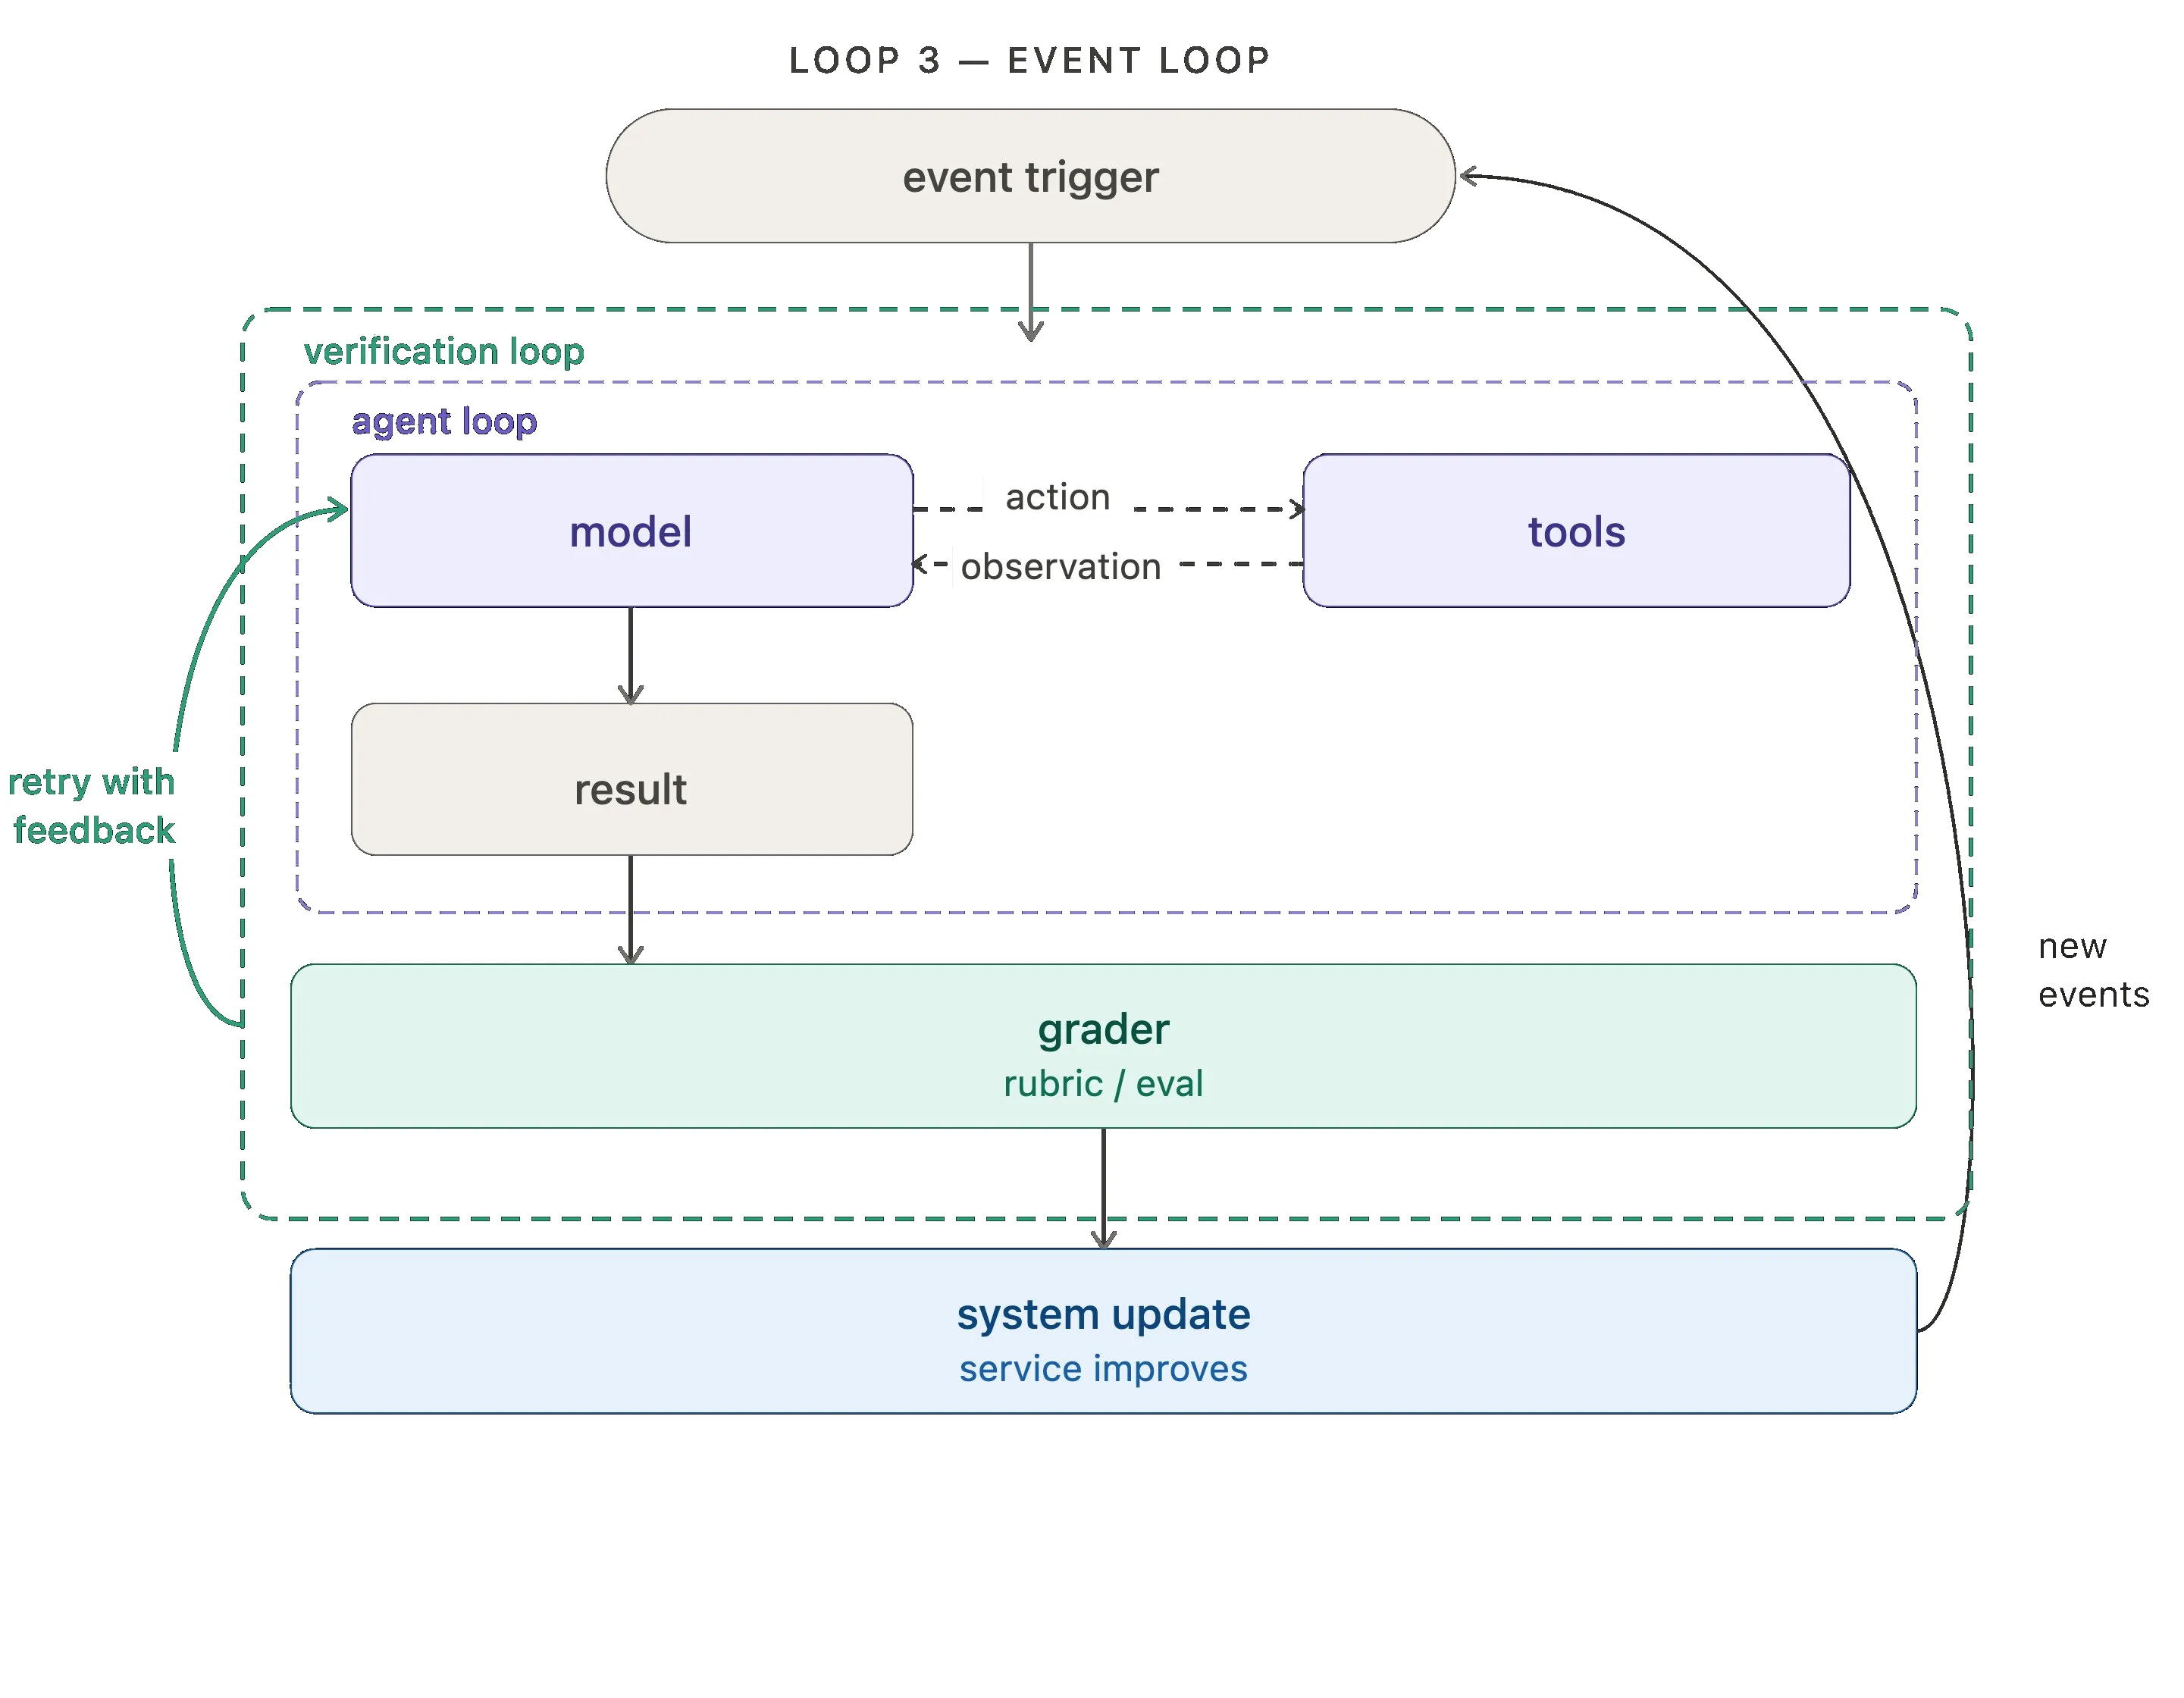
Ovenstående model udpeger 3 faser givet en event trigger
- Opgave Udførelse: Her sker de handlinger som agenten er defineret til at udføre, den gør brug af de værktøjer som er tilgængelige. Eksterne værktøjer er ofte forbundet via MCP
- Evaluering: Resultatet af opgaven bliver derefter evalueret. I mange tilfælde kan man få en anden agent til at udføre evalueringen.
- System opdatering: Til sidst bliver evalueringen af opgaven brugt til at forbedre de næste iterationer af agentens opgave.
Det vildeste med det her er at det kun er modellen for potentielt en enkel agent. Men hvad så hvis vi begynder at få agenterne til at snakke sammen ? Anthropic har præsenteret en ny AI Agent strategi som de kalder Multiplayer Agents. Herunder ses en grafik af deres forestilling
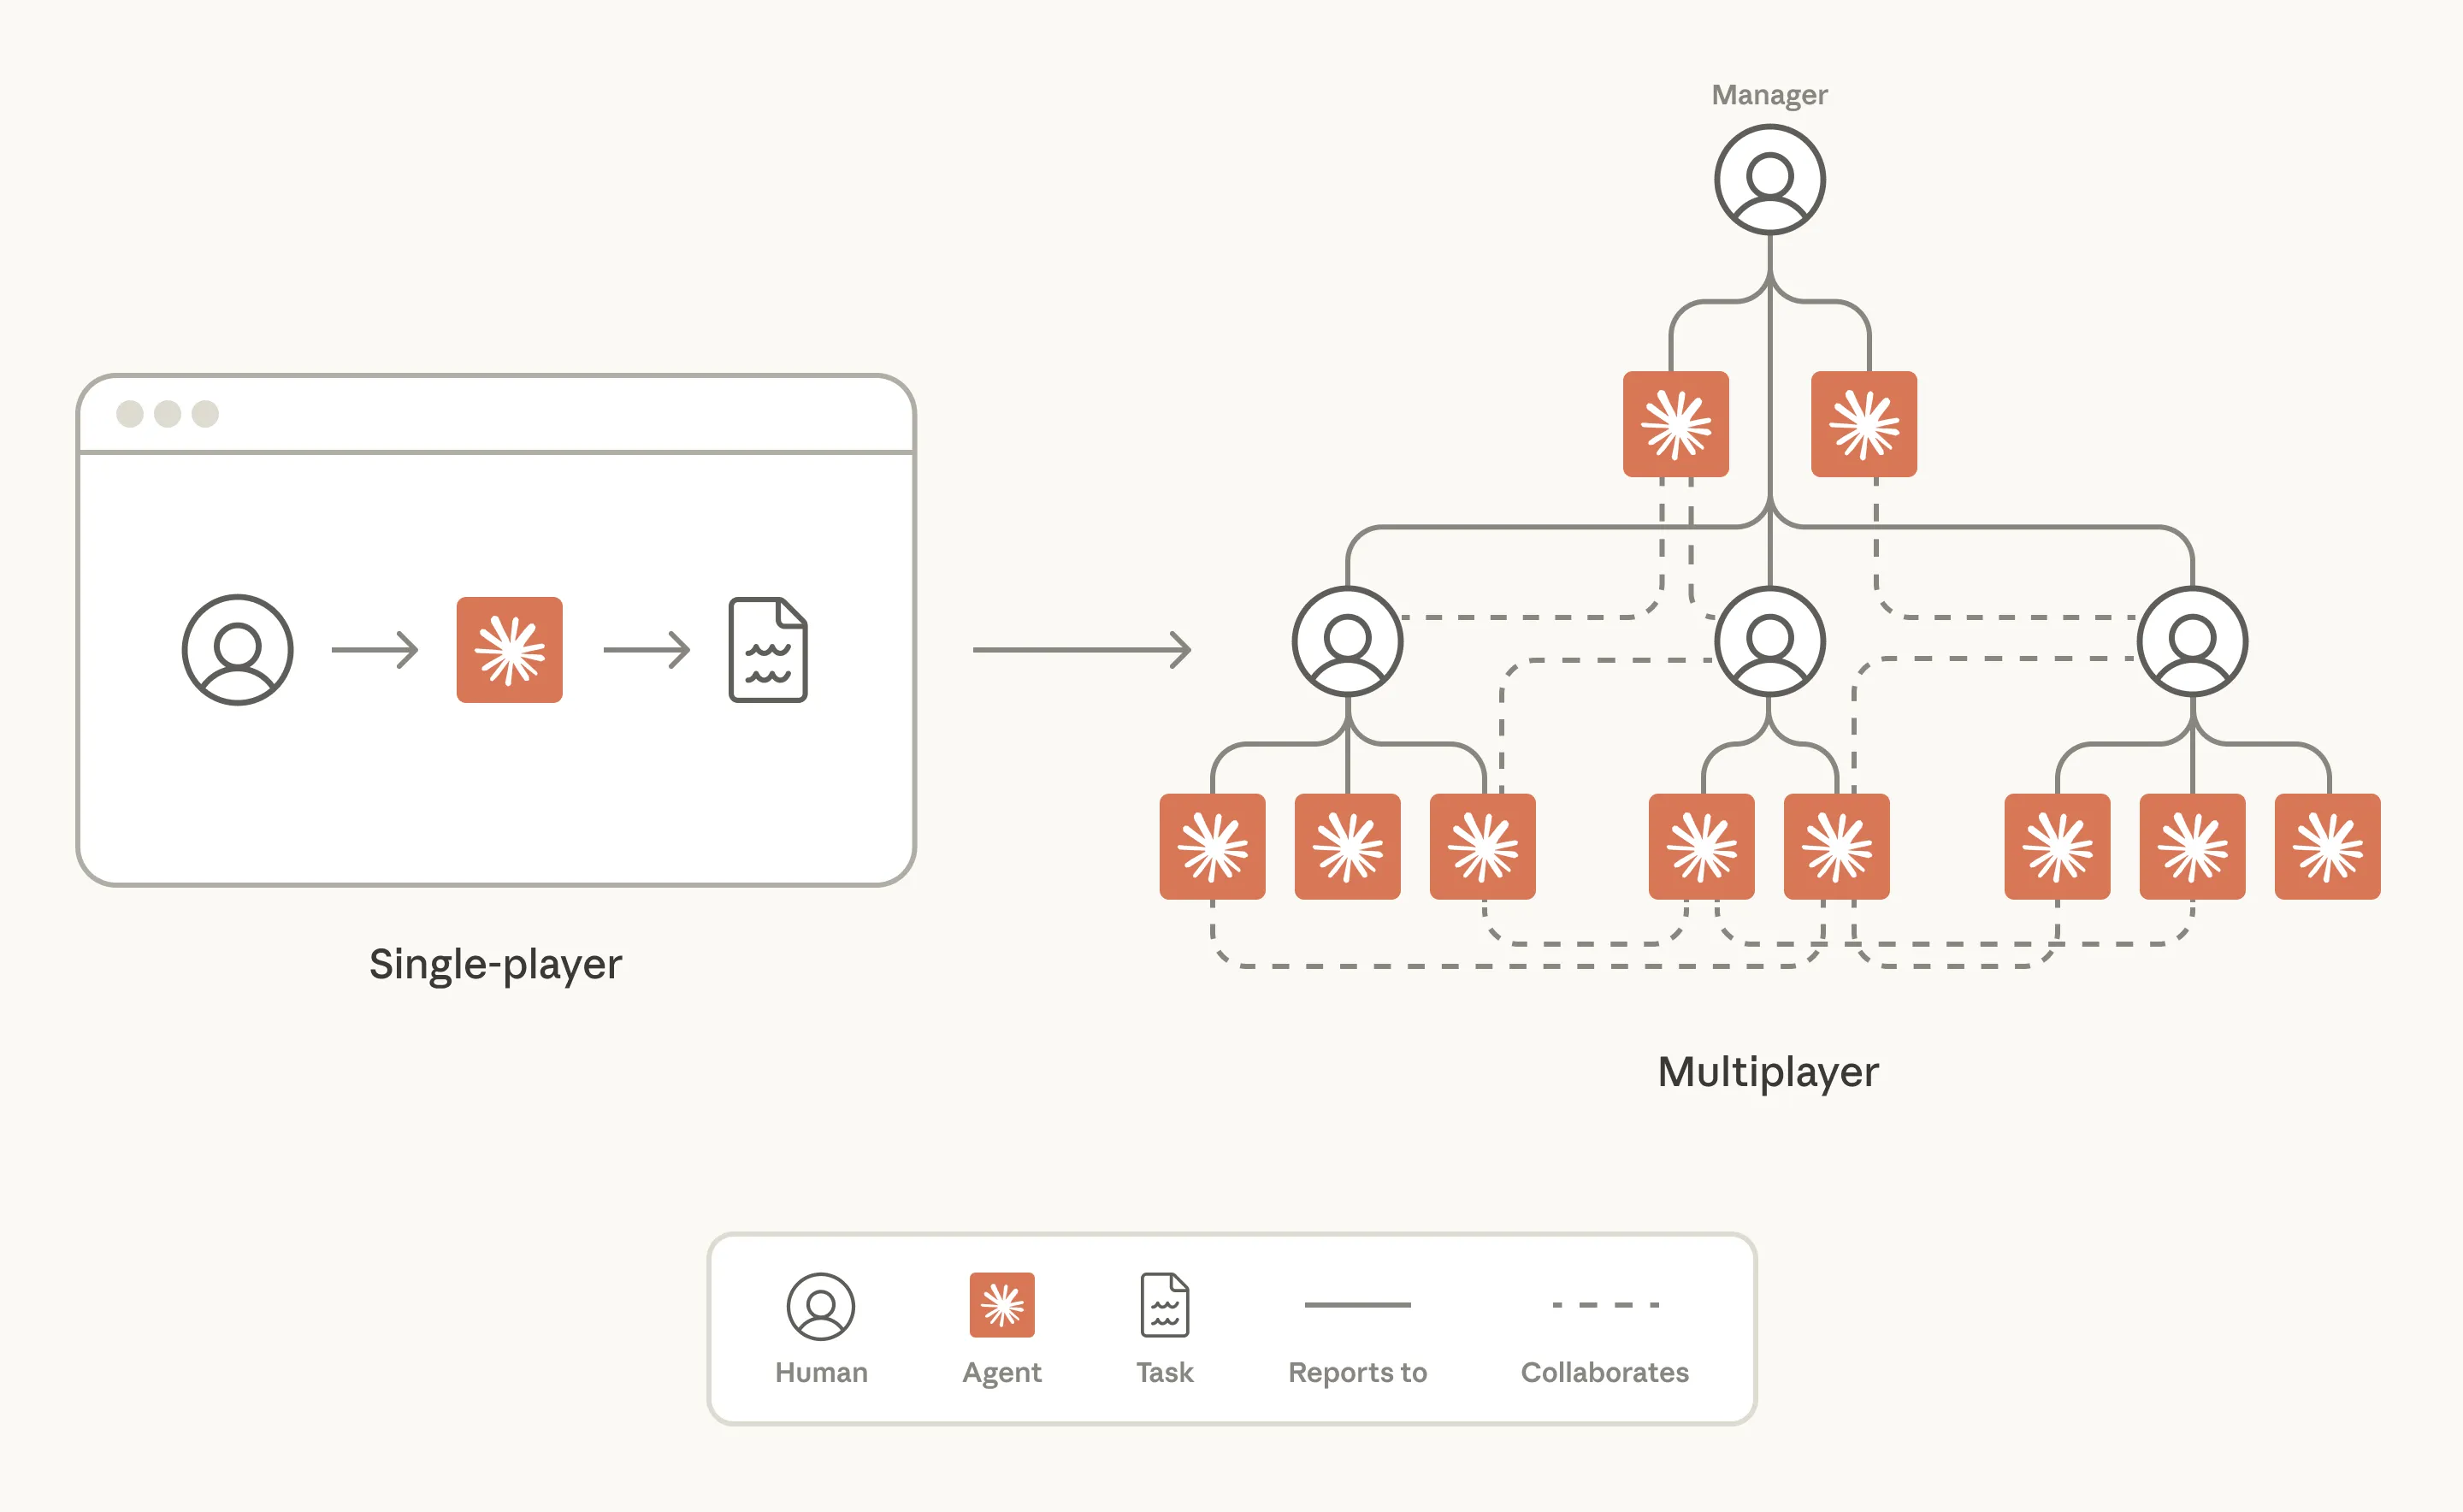
Ideen er at agenter og mennesker skal eksistere samtidigt, hvor der opsættes hierakiske strukturer som begrænser agenternes scope. Jeg kan ikke være den eneste der syntes det her lyder ret vanvittigt. Altså er vi allerede der hvor AI bare overtager verden?
Nå… men imens tech-giganterne dræner verdens ressourcer for til sidst at udslette menneskeligheden, så kan vi andre prøve at forholde os til hvor vi i vores hverdag kan begynde at anvende agenter. Jeg har derfor forsøgt mig med en 5 punkt tjekliste, som man kan prøve at anvende i ens organisation for at forholde sig til om nogen af de daglige opgaver man har potentielt kan blive autonomiseret af en AI agent.
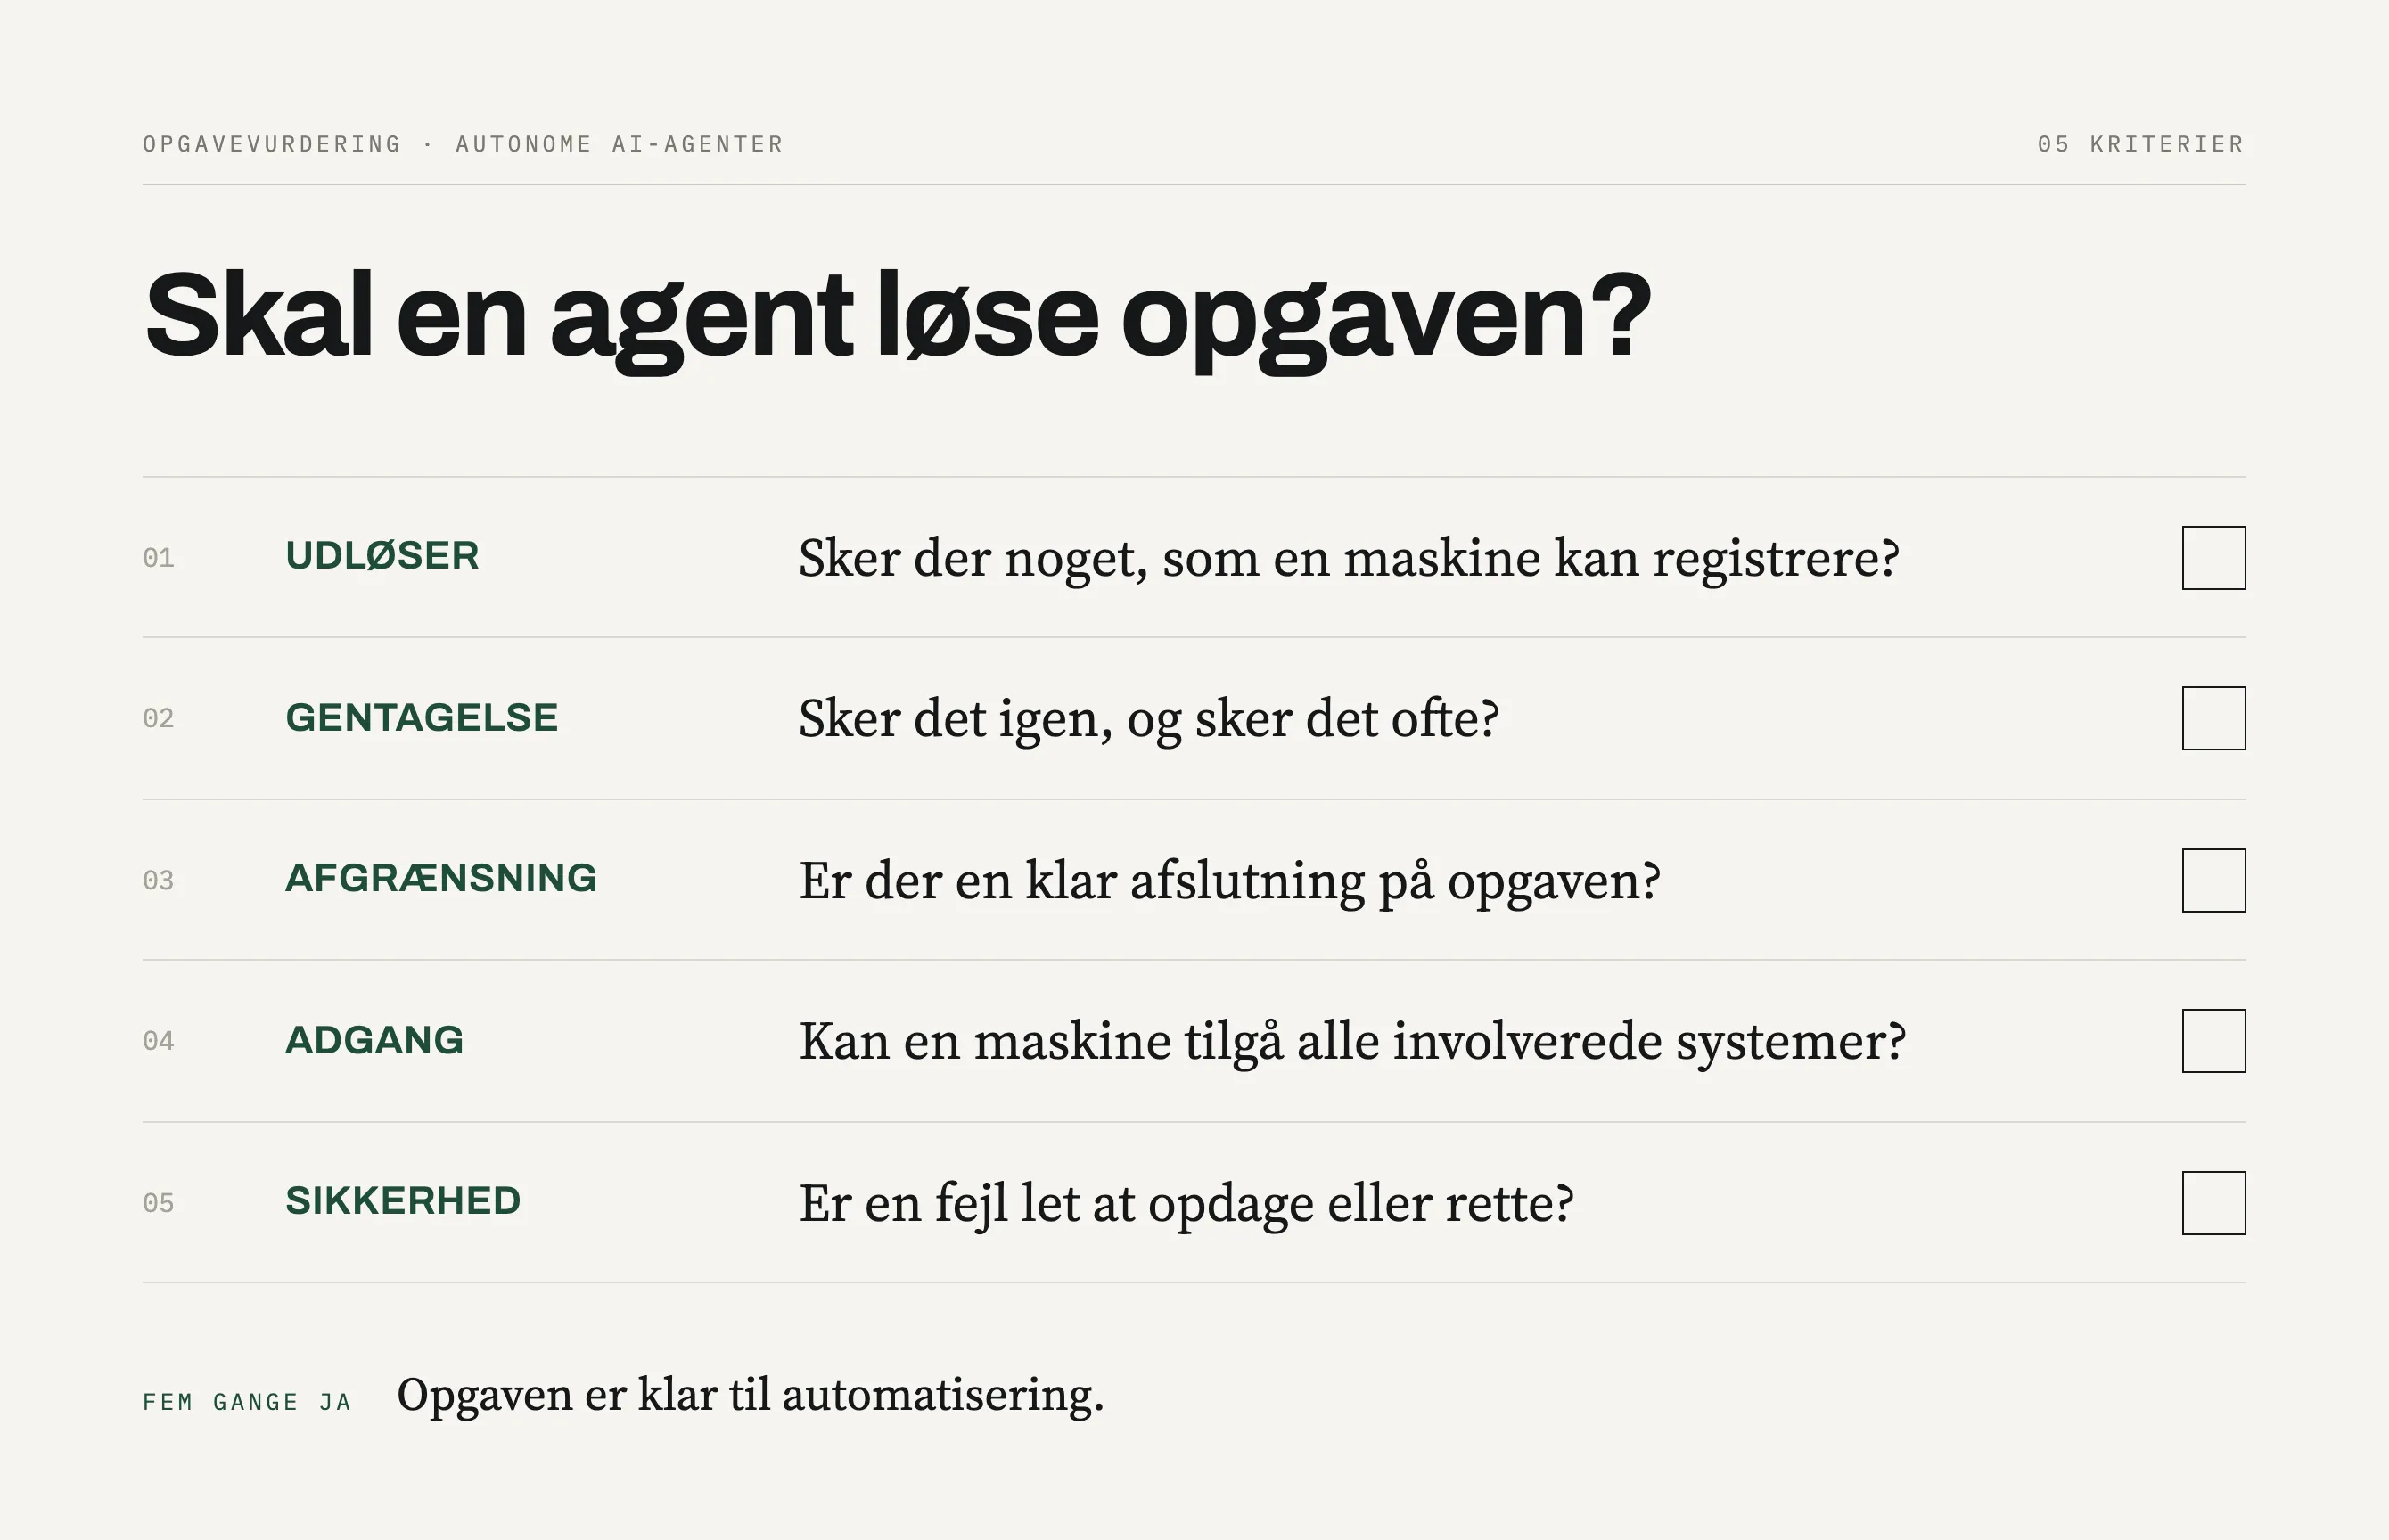
Det vilde er at denne simplificering er potentielt ikke engang nødvendig længere. Det viser sig nu at modellerens evne til at løse såkaldte “open-ended problems”, er blevet ekstremt gode. Det er problemer som ikke nødvendigvis har et fast mål eller klare instruktioner. Herunder ses en undersøgelse lavet på interne arbejdsopgaver ved Anthropic.
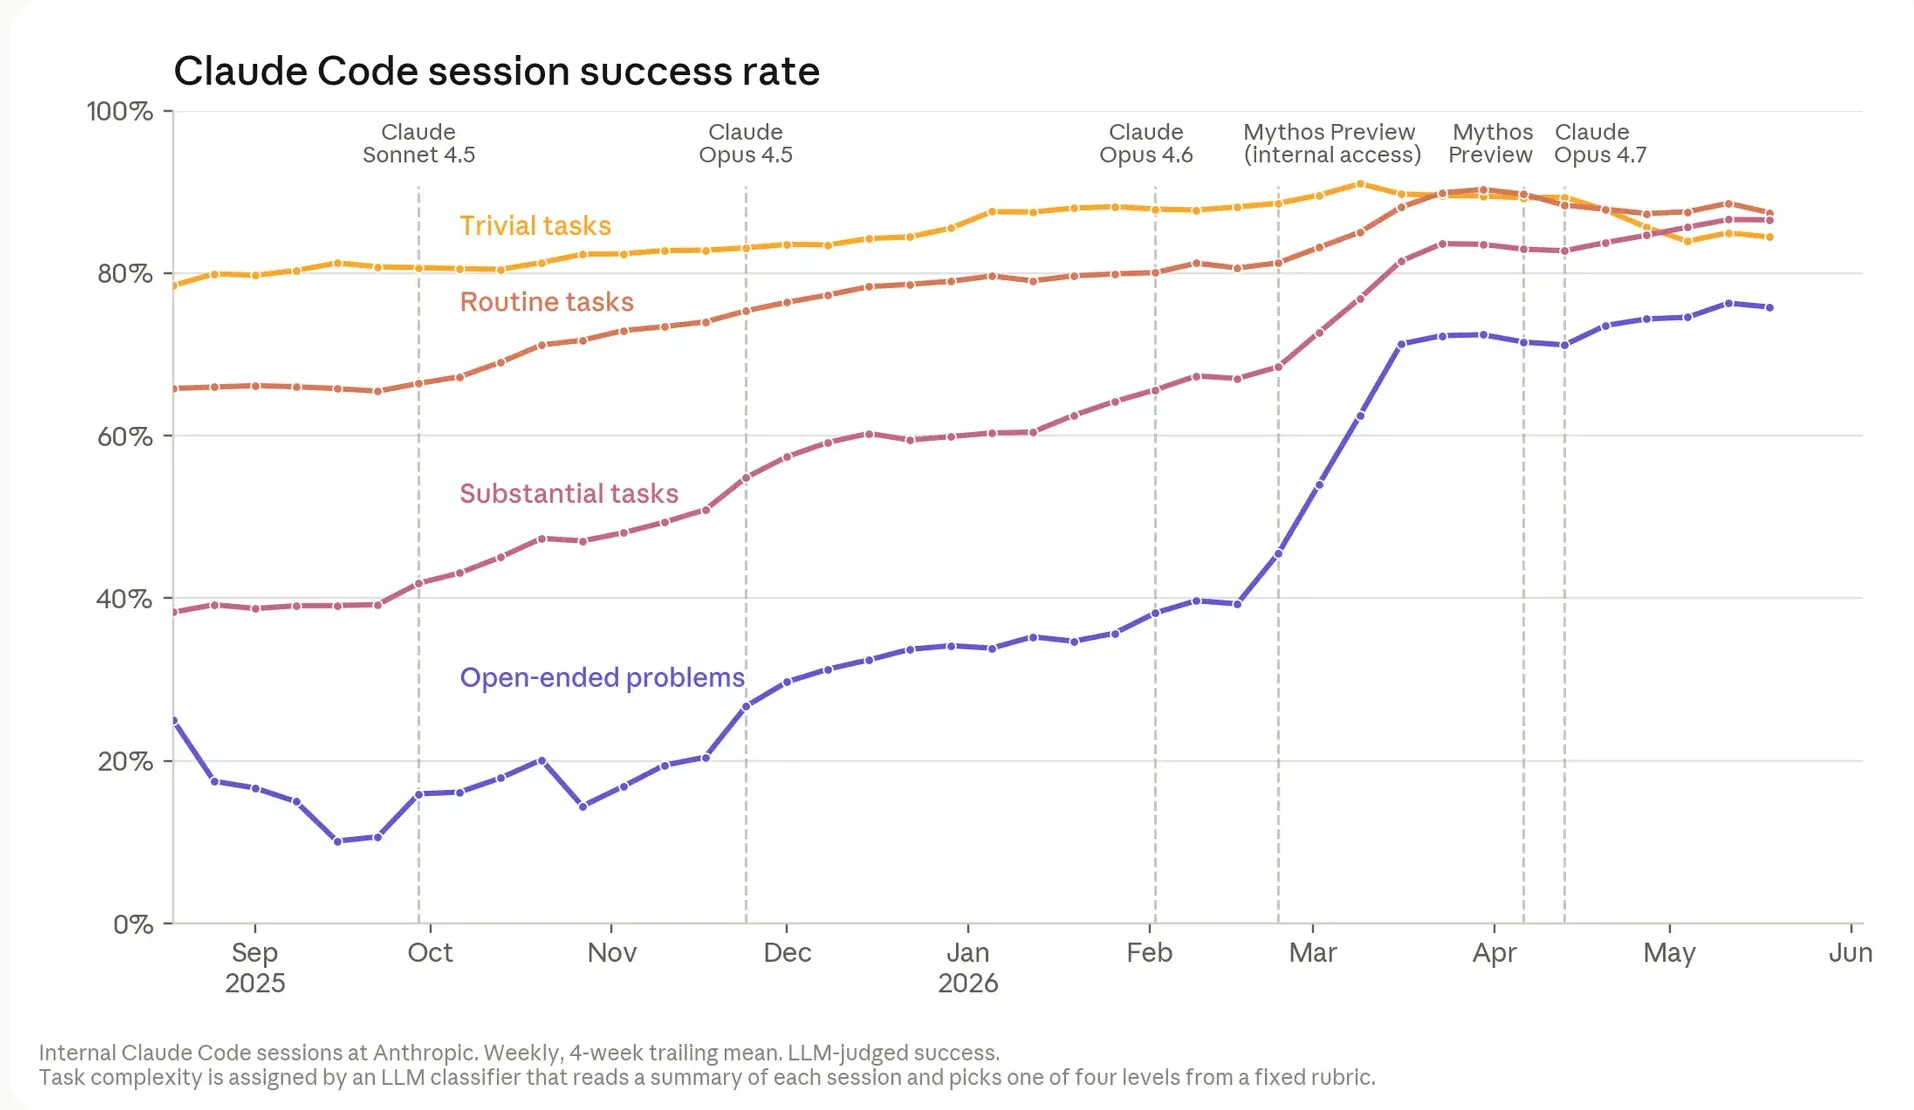
Bare indenfor det seneste år, er claude modellens evne til at løse udefinerede problemer steget fra 20% til 70% succesrate. Det syntes jeg er ret vanvittigt og som software udvikler til daglig har jeg også kunne mærke en kæmpe stigning i deres evne til at skrive kode og løse fejl.
Hvis man ønsker at læse mere om dette emne vil jeg helt klart anbefale Anthropic’s indslag omkring recursive self-improvement
Tak for din tid :)
Hvorfor jeg skriver her
Jeg starter denne blog side fordi jeg gerne vil være bedre til at dele mine holdninger. Jeg tror nemlig ved at gøre det, er der større chance for at de enten bliver valideret eller modbevist. På den måde kan jeg få en bedre fornemmelse for virkeligheden.
Så det her er stedet, hvor de kommer til at ligge.
Hvad jeg kommer til at skrive om
Det har jeg ikke helt besluttet mig for endnu. Jeg starter ud med lidt AI, og derefter må vi se hvad der interesserer mig.
Jeg har også en stor interesse for forretning og iværksætteri.
Hvordan det kommer til at foregå
Jeg skriver på dansk. Der hvor det giver mening oversætter jeg til engelsk.
Man er meget velkommen til at skrive sine egene indvendinger eller modsvar til emnet i kommentar feltet på LinkedIn. Det vil gavne rigtig meget.